Papers
* denotes equal contribution.
At Stanford
-
Harbor Adapters and Harbor-Index: Infrastructure and a Curated Meta-Dataset for Large-Scale Agentic Evaluation
Harbor Adapter TeamNeurIPS 2026, Evaluations and Datasets Track
-
OpenThoughts-Agent: Data Recipes for Agentic Models
OpenThoughts-Agent TeamarXiv 2026
-
UniT: Unified Multimodal Chain-of-Thought Test-time Scaling
Leon Liangyu Chen, Haoyu Ma, Zhipeng Fan, Ziqi Huang, Animesh Sinha, Xiaoliang Dai, Jialiang Wang, Zecheng He, Jianwei Yang, Chunyuan Li, Junzhe Sun, Chu Wang, Serena Yeung-Levy, Felix Juefei-XuCVPR 2026
-
Terminal-Bench: Benchmarking Agents on Hard, Realistic Tasks in Command Line Interfaces
Terminal-Bench TeamICLR 2026
-
OpenThoughts: Data Recipes for Reasoning Models
OpenThoughts TeamICLR 2026 Oral
-
The Impact of Image Resolution on Biomedical Multimodal Large Language Models
Liangyu Chen, James Burgess, Jeffrey J Nirschl, Orr Zohar, Serena Yeung-LevyMLHC 2025
-
BIOMEDICA: An Open Biomedical Image-Caption Archive, Dataset, and Vision-Language Models Derived from Scientific Literature
Alejandro Lozano*, Min Woo Sun*, James Burgess*, Liangyu Chen, Jeffrey J Nirschl, Jeffrey Gu, Ivan Lopez, Josiah Aklilu, Austin Wolfgang Katzer, Collin Chiu, Anita Rau, Xiaohan Wang, Yuhui Zhang, Alfred Seunghoon Song, Robert Tibshirani, Serena Yeung-LevyCVPR 2025
-
Diversify and Conquer: Diversity-Centric Data Selection with Iterative Refinement
Simon Yu*, Liangyu Chen*, Sara Ahmadian, Marzieh FadaeeICML 2025 Workshop on DataWorld
Before Stanford
-
MMLongBench-Doc: Benchmarking Long-context Document Understanding with Visualizations
Yubo Ma*, Yuhang Zang*, Liangyu Chen, Meiqi Chen, Yizhu Jiao, Xinze Li, Xinyuan Lu, Ziyu Liu, Yan Ma, Xiaoyi Dong, Pan Zhang, Liangming Pan, Yu-Gang Jiang, Jiaqi Wang, Yixin Cao, Aixin SunNeurIPS 2024, Datasets and Benchmarks Track Spotlight
-
MMInA: Benchmarking Multihop Multimodal Internet Agents
Shulin Tian*, Ziniu Zhang*, Liangyu Chen*, Ziwei LiuACL Findings 2025
-
Aurora-M: The First Open Source Multilingual Language Model Red-teamed according to the U.S. Executive Order
Aurora-M TeamCOLING 2025, Industry Track
-
Benchmarking and Analyzing Generative Data for Visual Recognition
Bo Li, Haotian Liu, Liangyu Chen, Yong Jae Lee, Chunyuan Li, Ziwei LiuTPAMI 2025
-
MIMIC-IT: Multi-Modal In-Context Instruction Tuning
Bo Li*, Yuanhan Zhang*, Liangyu Chen*, Jinghao Wang*, Fanyi Pu*, Jingkang Yang, Chunyuan Li, Ziwei LiuarXiv 2023
-
Otter: A Multi-Modal Model with In-Context Instruction Tuning
Bo Li*, Yuanhan Zhang*, Liangyu Chen*, Jinghao Wang*, Fanyi Pu*, Joshua Adrian Cahyono, Jingkang Yang, Ziwei LiuTPAMI 2025
-
Large Language Models are Visual Reasoning Coordinators
Liangyu Chen*, Bo Li*, Sheng Shen, Jingkang Yang, Chunyuan Li, Kurt Keutzer, Trevor Darrell, Ziwei LiuNeurIPS 2023; ICLR 2023 Workshop on Mathematical and Empirical Understanding of Foundation Models
-
Panoptic Video Scene Graph Generation
Jingkang Yang, Wenxuan Peng, Xiangtai Li, Zujin Guo, Liangyu Chen, Bo Li, Zheng Ma, Wayne Zhang, Kaiyang Zhou, Chen Change Loy, Ziwei LiuCVPR 2023
-
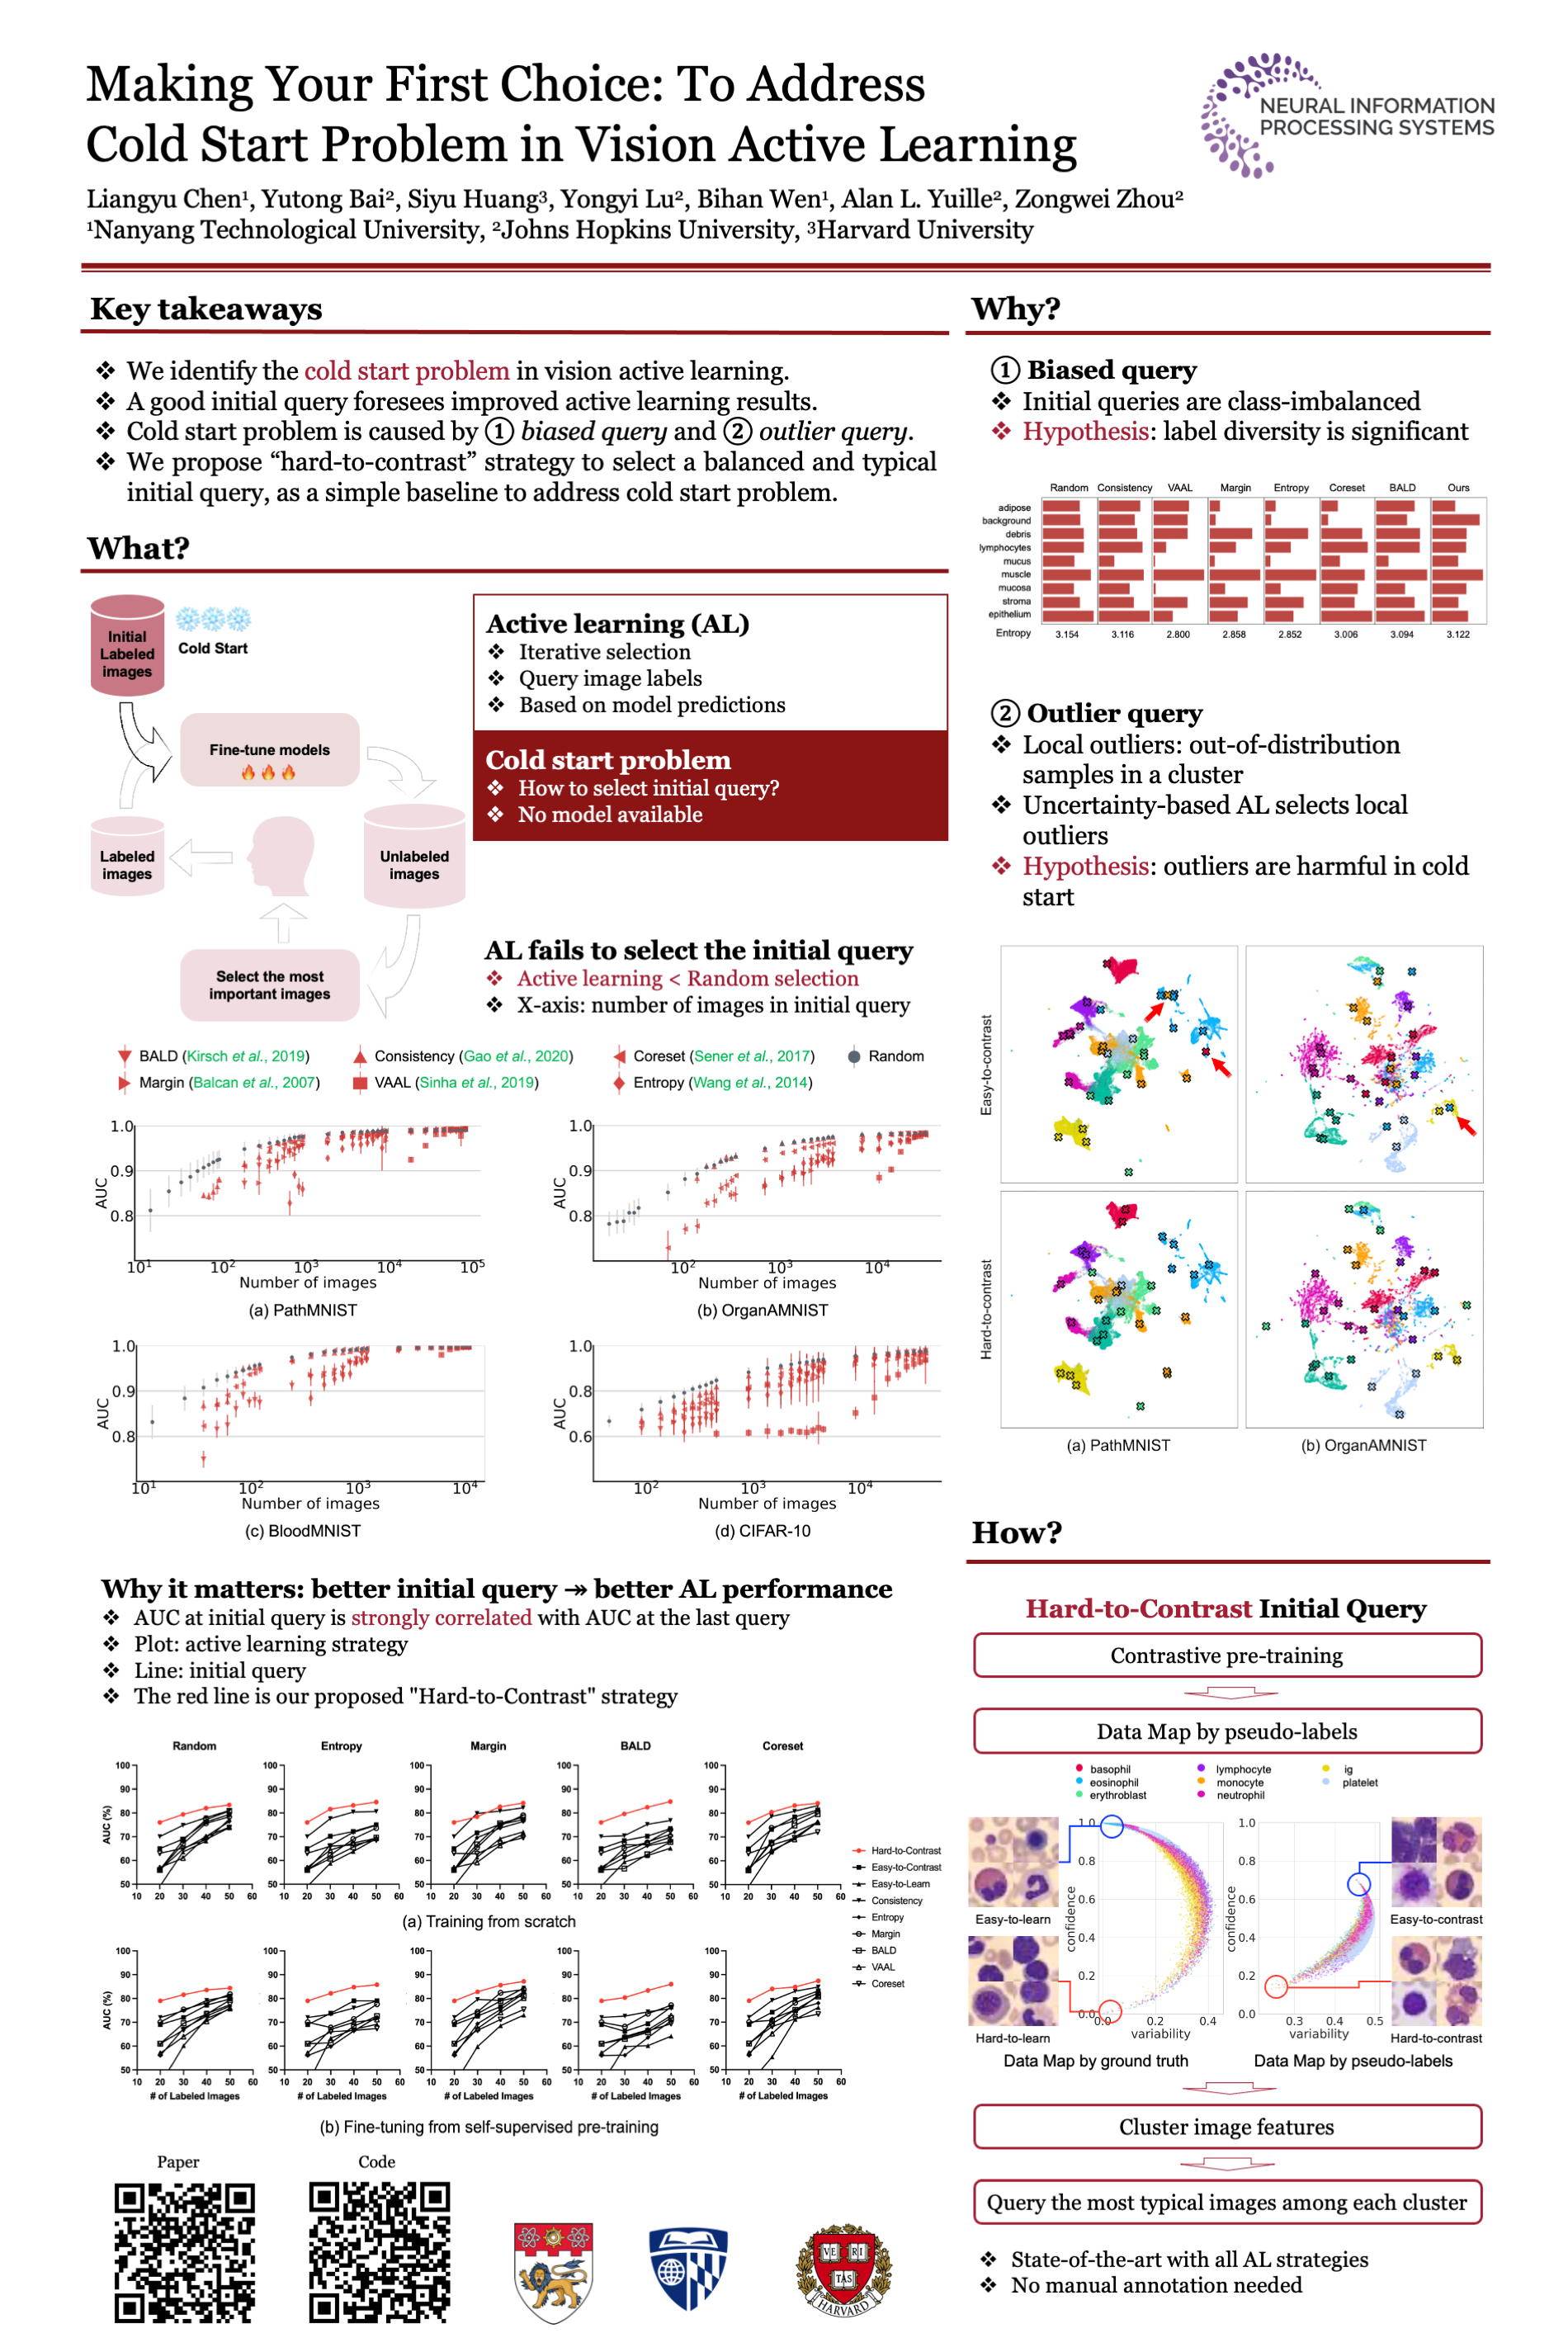
Making Your First Choice: To Address Cold Start Problem in Vision Active Learning
Liangyu Chen, Yutong Bai, Siyu Huang, Yongyi Lu, Bihan Wen, Alan Yuille, Zongwei ZhouMIDL 2023; RSNA 2024 Abstracts; NeurIPS 2022 Workshop on Human in the Loop Learning
-
Automatic Calcification Morphology and Distribution Classification for Breast Mammograms with Multi-task Graph Convolutional Neural Network
Hao Du, Melissa Min-Szu Yao, Siqi Liu, Liangyu Chen, Wing P. Chan, Mengling FengJBHI 2023
-
Baconian: A Unified Open-source Framework for Model-Based Reinforcement Learning
Linsen Dong, Guanyu Gao, Xinyi Zhang, Liangyu Chen, Yonggang WenarXiv 2020